



Що таке контекстне вікно та токени в LLM?
Стаття також доступна російською (перейти до перегляду).
Під час роботи із сервісами на основі великих мовних моделей, такими як ChatGPT, Claude або Gemini, користувач може помітити, що в довгій розмові система перестає враховувати деякі згадані раніше деталі. Це не означає, що штучний інтелект забуває інформацію так само, як людина. Причина полягає в обмеженому обсязі даних, які мовна модель може обробити одночасно. Щоб зрозуміти, як працює це обмеження, потрібно розібратися, що таке контекстне вікно та токени в LLM.
Що таке контекстне вікно?
Простими словами, контекстне вікно – це весь обсяг інформації, якою модель може одночасно оперувати в межах однієї розмови. Не варто плутати контекстне вікно з даними, на яких навчалася велика мовна модель. Величезний корпус текстів, використаний під час тренування, залишається «у минулому» – LLM не звертається до нього напряму.
Натомість контекстне вікно – це щось на кшталт робочої пам’яті: як аркуш паперу, на якому поміщається лише обмежена кількість інформації. Його місткість визначає, наскільки довгим і складним може бути запит і як довго модель «тримає в пам’яті» історію діалогу в межах однієї розмови.
Що таке токени?
Оскільки контекстне вікно вимірюється токенами, варто розібратися в тому, чим вони є і яку роль виконують. Токен – це певний фрагмент тексту, а не ціле слово. Токенізатор розбиває вхідні дані на токени (виконує токенізацію), і одне слово, наприклад, довге чи рідкісне, може складатися з кількох елементів одночасно.
Українська мова через свою морфологію зазвичай «коштує» більше токенів LLM, ніж англійська – це варто враховувати, плануючи довгі запити. Мультимодальні дані, наприклад, зображення чи PDF-файли, теж займають частину контекстного вікна, але їх токенізація відбувається за іншими правилами.
Як пов’язані токени та контекстне вікно?
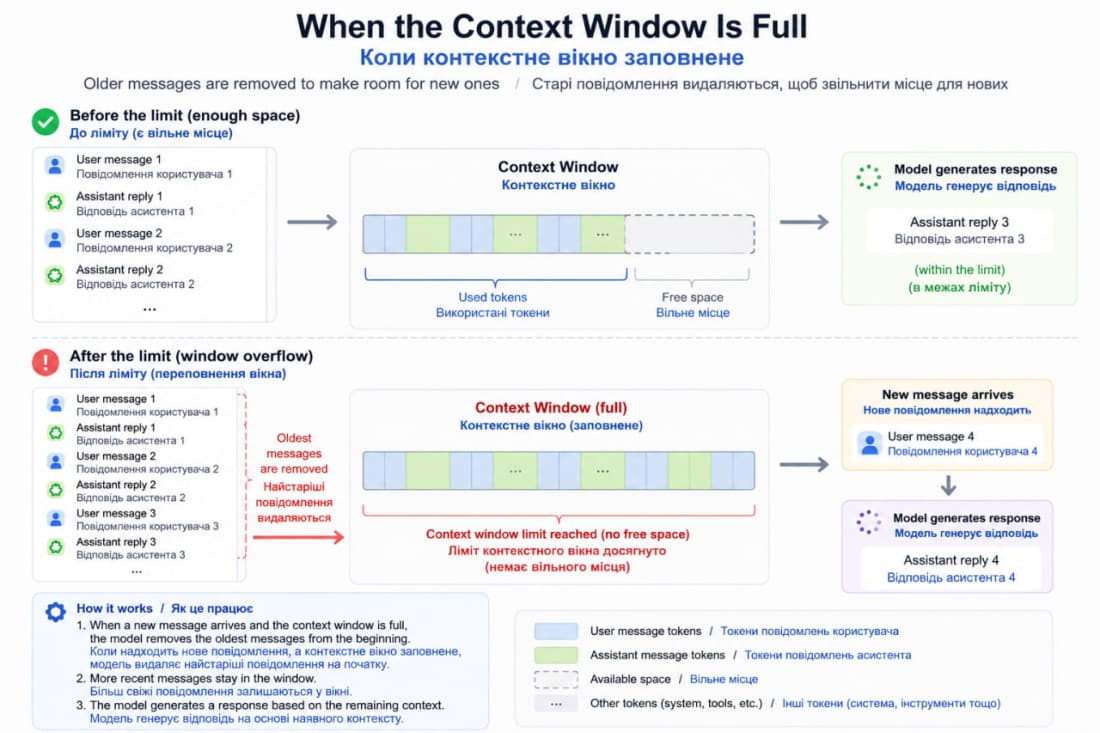
Контекстне вікно LLM можна уявити як контейнер, який наповнюють піском (токенами). Його об’єм обмежений певною кількістю частин, залежно від версії моделі.
Довжина контексту включає усе:
-
системний промпт (system prompt) – загальна інструкція для генерування, закладена під час розробки;
-
всі повідомлення користувача;
-
попередні відповіді моделі, включно з результатами роботи інструментів, зображеннями та документами;
-
додатковий контекст;
-
вихідні токени – тобто відповідь LLM, яку вона генерує просто зараз.
Сума вхідних та вихідних токенів не може бути безмежною, тому варто надавати пріоритет найважливішим даним, якою б важливою не здавалася вся попередня інформація.
Чому модель «забуває» початок діалогу?
Коли історія діалогу стає надто довгою і перевищує обмеження контексту, настає контекстне переповнення: найстаріші токени або відкидаються, або стискаються, щоб звільнити місце для нових. Виглядає так, ніби мовна модель «забула» початок розмови, хоча насправді йдеться про технічне обмеження, а не про справжню довгострокову пам’ять.
Чому більше контексту – не завжди краще?
Здавалося б, чим більше контекстне вікно, тим краще – можна вставити цілу книгу та попросити LLM її проаналізувати. Але в такого підходу є значні нюанси, які знижують ефективність та якість відповідей моделі:
-
Зростають витрати ресурсів – чим більше токенів ви витрачаєте, тим дорожчий тип підписки буде потрібен.
-
З’являється context rot – зі зростанням кількості токенів точність і здатність пригадувати конкретні деталі поступово падають. Увага моделі ніби «розмивається» через зайвий контекст, тому генерація тексту може бути менш релевантною запиту.
Тому питання не лише в тому, які обмеження контексту існують технічно, а й у тому, чим його варто наповнювати. Це напряму перетинається з prompt engineering – вмінням формулювати промпт так, щоб штучний інтелект отримав тільки потрібну інформацію.
Практичні поради
Тож як писати prompt з урахуванням обмежень контекстного вікна? Ось кілька правил, які допоможуть ефективно працювати з LLM:
-
Діліть великі задачі на менші. Розбийте проєкт на логічні частини, а не включайте всі деталі одразу. Так зменшиться ризик контекстного переповнення і context rot.
-
Прибирайте зайве з діалогу. Якщо історія діалогу вже не потрібна для поточного завдання, почніть новий чат – це звільнить контекстне вікно LLM від шуму й покращить якість відповіді.
-
Для великих документів використовуйте RAG або завантаження файлів, а не копіюйте текст у чат. Retrieval-Augmented Generation дозволяє моделі звертатися лише до релевантних фрагментів, а не тримати весь документ у робочій пам’яті одночасно.
-
Формулюйте запит чітко. Хороший prompt економить токени і зменшує ризик, що штучний інтелект «загубить» суть завдання серед зайвих деталей.
Розуміння, що таке токени та контекстне вікно, значно підвищує ефективність роботи з великими мовними моделями. Урахування технічного ліміту допомагає грамотно наповнювати промпт і отримувати точні та релевантні відповіді.
Прискорте свої AI-моделі з GPU-сервером FREEhost.UA
Оберіть сервер для AI AMD Ryzen 5 5600G — потужне рішення для навчання та роботи з нейронними мережами.
Надійна інфраструктура, цілодобова підтримка та український дата-центр — усе для ваших AI-проєктів.