



Що таке AI inference?
Стаття також доступна російською (перейти до перегляду).
AI inference – це процес використання натренованої моделі ШІ для отримання результатів на нових даних. Inference-модель застосовує вивчені закономірності, щоб класифікувати, прогнозувати або генерувати потрібну користувачу відповідь. Вона повністю імітує людські інтелектуальні здібності, зокрема, мислення та мовлення.
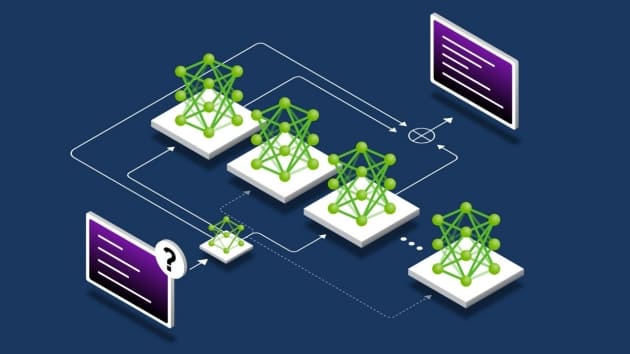
Якщо пояснити простими словами, що таке AI inference, то це – застосування моделлю здобутих знань на практиці. А щоб інференс ШІ був ефективним та прикладним, модель перед використанням активно тренують.
Чим inference відрізняється від навчання моделі
Навчання моделі (training) – це важкий і ресурсомісткий процес в контексті розвитку нейронної мережі. Модель обробляє мільярди прикладів та вчиться розпізнавати закономірності, використовуючи кластери потужних GPU впродовж тижнів. Саме за допомогою машинного навчання (ML) налаштовуються параметри моделі, за якими вона працюватиме далі.
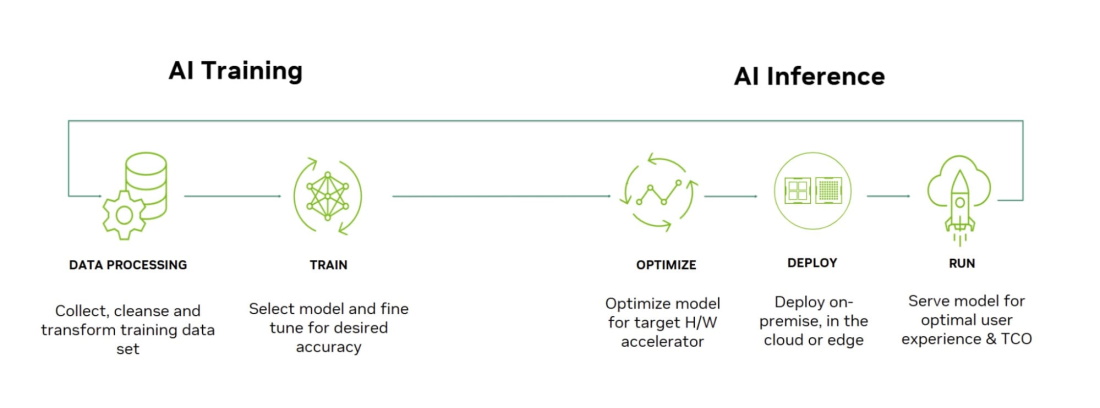
А от Inference в AI – набагато легший процес, коли велика мовна модель (LLM) застосовує до нового запиту те, чого навчилася. Обробка запитів до AI та генерація результату відбуваються досить швидко.
| Відмінності | Навчання моделі (training) | AI inference |
|---|---|---|
| Концепт | Здобуття навички | Застосування навички |
| Принцип роботи | Аналіз мільйонів прикладів, коригування внутрішніх параметрів, щоб мінімізувати похибки | Для обробки вхідного сигналу та виведення результату використовуються фіксовані параметри, які були вивірені на попередньому етапі машинного навчання для inference |
| Частота використання | Один раз на версію | Працює безперервно, обробляючи щодня мільярди запитів |
Якщо порівнювати з людиною, то навчання – це роки в школі та університеті, а inference – це момент, коли відбувається дія на основі них. Наприклад, коли лікар ставить діагноз та призначає лікування або програміст пише та тестує код.
Як працює inference в LLM
Велика мовна модель (LLM) генерує результат, використовуючи токени AI – невеликі фрагменти слів, символів, пікселів. Модель аналізує послідовність токенів і по черзі прогнозує наступний токен, поки не сформує повну відповідь.
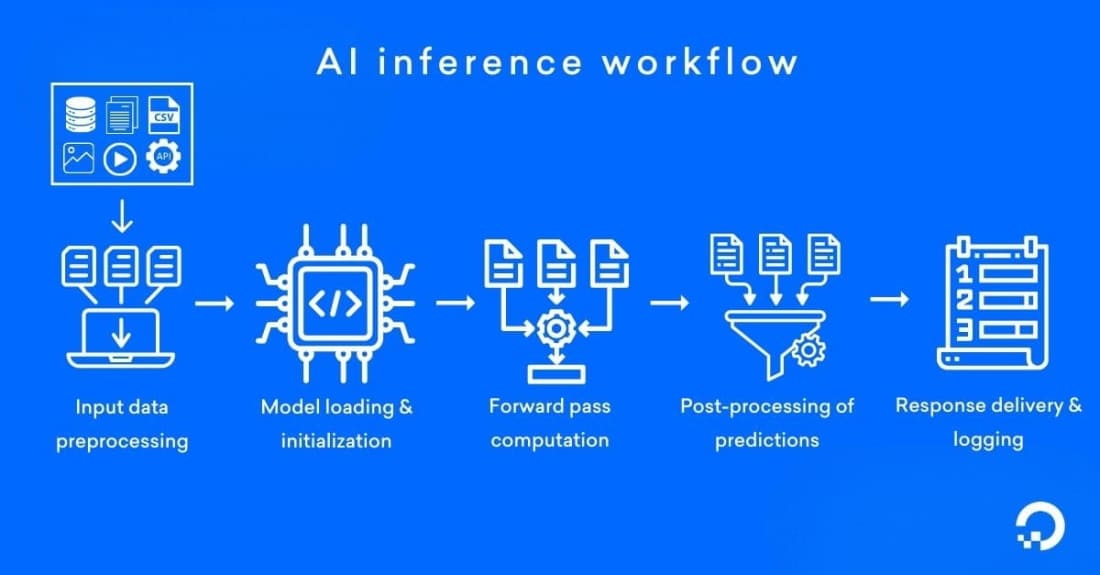
Швидкість роботи inference LLM залежить від кількох факторів:
-
розміру моделі;
-
потужності GPU/TPU;
-
довжини контексту;
-
кількості токенів у відповіді;
-
наявності оптимізації моделі.
Найбільше швидкість відповіді моделі уповільнюється під час генерації нових токенів, оскільки це залучає більше обчислювальних ресурсів AI.
Де використовується AI inference
Оскільки AI inference – це практичне застосування можливостей нейромережі, то основні сфери його використання майже необмежені. Насамперед це:
-
чат-боти та асистенти, які відповідають на запитання в реальному часі;
-
пошук – алгоритми використовують моделі для розуміння запитів;
-
створення контенту – AI-генерація текстів, зображень, відео, аудіо;
-
розпізнавання облич – аналіз нових фото та порівняння з базою;
-
керування безпілотними системами – обробка інформації з камер у потоці руху і прийняття рішення про дію.
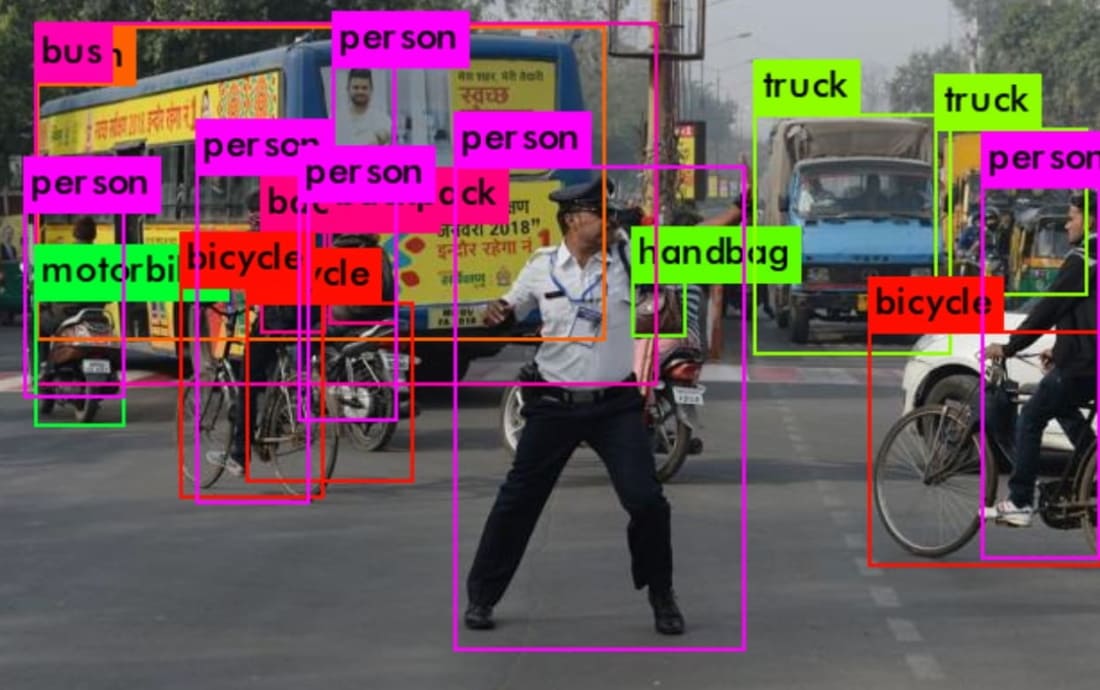
Існує кілька типів того, як інференс ШІ може виглядати на практиці.
| Параметри порівняння | Тип інференсу | |
|---|---|---|
| Вид обробки | Batch inference – пакетна обробка, де велика кількість запитів обробляється у фоновому режимі | Online inference – відповідь генерується одразу після запиту, у реальному часі |
| Як передається результат | Streaming inference – генерація відбувається токен за токеном | One-shot inference – результат видається цілком |
| Місце розгортання | Edge AI inference – запускається безпосередньо на пристрої (смартфон, камера, IoT-сенсор), дані нікуди не передаються | Cloud inference – взаємодія відбувається за допомогою протоколів Інтернету |
Ці параметри не є несумісними, наприклад, Claude є прикладом online-, streaming- та cloud-inference.
Чи можна запускати inference на VPS або виділеному сервері
Запуск inference на сервері або VPS – поширене рішення. Його можна реалізувати:
-
у хмарному сервісі – зручно і масштабовано, але вартість зростає разом із навантаженням;
-
self-hosted на виділеному сервері з GPU – це дає повний контроль над даними та нижчу вартість у довгостроковій перспективі;
-
на VPS без GPU – підходить лише для невеликих або квантизованих моделей.
Конкретне рішення для кожного випадку залежить від необхідної продуктивності та бюджету.
Висновок
Що таке AI inference? Це етап після машинного навчання (ML), де нейромережа застосовує набуті знання для обробки нових запитів і генерації результату. AI inference є основою всіх ШІ-можливостей (чат-ботів, генерації контенту, пошуку, розпізнавання облич). Його можна запускати як у хмарі, так і на VPS або виділених GPU-серверах залежно від навантаження та бюджету.