


Ми впевнені, що серед наших клієнтів є багато професіоналів IT, які працюють над цікавими проектами. Якщо у Вас виникає бажання розповісти про них, Ви можете розмістити статтю у нашому блозі. А щоб було цікавіше, ми зробили конкурс статей, щомісяця три переможці отримуватимуть призи.
Стаття також доступна російською (перейти до перегляду).
Зміст:
Чи можна запустити власну мовну модель на звичайному VPS, чи для цього обов'язково потрібен потужний сервер із GPU? Все залежить від розміру моделі, обсягу оперативної пам'яті та вимог до швидкості її роботи. Наприклад, для запуску невеликої LLM із 3 мільярдами параметрів може вистачити звичайного VPS, тоді як модель із 30 мільярдами параметрів потребуватиме значно більше ресурсів.
У цій статті розберемося, як правильно підібрати сервер для Ollama: скільки потрібно RAM і VRAM, коли достатньо процесора без відеокарти, а коли варто обирати GPU. Також розглянемо конкретні конфігурації серверів для запуску моделей різного розміру.
Що таке Ollama і навіщо власна LLM
Ollama — інструмент для запуску мовних моделей на власному обладнанні. Він працює на Linux, macOS та Windows, завантажує моделі з каталогу однією командою і відкриває до них HTTP API. У каталозі є Llama, Qwen, Gemma та десятки інших сімейств. Моделі поширюються у форматі GGUF: один файл GGUF містить ваги та метадані.
Запуск Ollama на сервері займає кілька хвилин, а запуск LLM локально обирають з практичних причин:
-
документи та листування не передаються сторонньому API;
-
немає оплати за кожен запит, витрати зводяться до оренди сервера;
-
модель підключається до внутрішніх систем: CRM, бази знань, тікет-системи;
-
можна зібрати внутрішнього асистента для співробітників;
-
локальна LLM підходить для RAG, обробки документів і класифікації текстів.
Головне правило: спочатку модель, потім сервер
Сервер для AI неможливо підібрати «взагалі». Спочатку визначають задачу та модель LLM під неї, і лише потім дивляться на апаратні ресурси. Локальні LLM однієї назви бувають у кількох розмірах, і апаратні ресурси під них різні. Llama 3.2 3B і Qwen3 30B відрізняються за розміром майже у десять разів, тому сервер для локальних LLM під першу і під другу — це різні класи обладнання.
На вимоги впливають шість речей:
-
скільки параметрів має модель LLM;
-
рівень квантизації;
-
контекстне вікно, тобто скільки тексту модель тримає в пам'яті одночасно;
-
одночасні запити від кількох користувачів;
-
де виконується інференс (inference) — на CPU чи на GPU;
-
потрібна швидкість генерації.
Що означають 3B, 8B, 14B, 30B
Літера B у назві — це мільярди параметрів: 3B ≈ 3 млрд, 8B ≈ 8 млрд, 14B ≈ 14 млрд, 30B ≈ 30 млрд. Чим більше параметрів, тим більше пам'яті потрібно, щоб тримати модель завантаженою. LLM розшифровується як велика мовна модель, і слово «велика» тут буквальне. Старша велика мовна модель зазвичай краще міркує і точніше дотримується інструкцій, але платити за це доводиться гігабайтами пам’яті.
Напряму перераховувати параметри в гігабайти не можна, бо є така річ, як квантизація. Вона зменшує розмір моделі та вимоги до пам'яті ціною певної втрати точності. Моделі в каталозі Ollama типово вже квантизовані, тому 8B займає близько 5 ГБ, а не 16 ГБ, як у повній точності.
Приклади реальних моделей
Розміри типових тегів у каталозі Ollama на момент підготовки матеріалу:
| Модель | Параметри | Розмір файлу |
|---|---|---|
| Llama 3.2 | 1B | ~1,3 ГБ |
| Llama 3.2 | 3B | ~2,0 ГБ |
| Qwen3 | 4B | ~2,5 ГБ |
| Qwen3 | 8B | ~5,2 ГБ |
| Gemma 3 | 12B | ~8,1 ГБ |
| Qwen3 | 14B | ~9,3 ГБ |
| Qwen3 | 30B | ~19 ГБ |
| Qwen3 | 32B | ~20 ГБ |
Розмір файлу — це нижня межа, а не потрібний обсяг RAM або VRAM. Крім ваги самої моделі пам'ять займають:
-
операційна система та процес Ollama;
-
контекст — токени запиту, історії діалогу та відповіді;
-
KV cache, проміжні дані для вже оброблених токенів;
-
паралельні запити, кожен зі своїм контекстом.
Типово Ollama виділяє контекстне вікно на 4096 токенів. Якщо збільшити його до 32 тисяч заради довгих документів, KV cache зросте пропорційно, і модель на 5 ГБ може зайняти вдвічі більше. За документацією Ollama, потреба в пам'яті під контекст множиться на кількість паралельних запитів. Тому запас потрібен завжди.
RAM для Ollama: скільки оперативної пам'яті потрібно
Коли відеокарти немає, модель повністю розміщується в оперативній пам'яті сервера. Саме RAM визначає, яка модель LLM взагалі завантажиться. Орієнтири для квантизованих моделей з типовим контекстом:
| Клас моделі | Орієнтир по RAM |
|---|---|
| 1–3B | 4–8 ГБ і більше |
| 4–8B | 8–16 ГБ і більше |
| 12–14B | 16–32 ГБ і більше |
| Близько 30B | 32–64 ГБ і більше |
| 70B | 64–128 ГБ і більше |
Це не системні вимоги, а точка відліку: реальні цифри залежать від моделі, квантизації та контексту. Підбираючи RAM для Ollama, беріть конфігурацію, де модель займає не більше двох третин пам'яті. Якщо вона впритул заповнює оперативну пам'ять, система йде у swap, і генерація тексту сповільнюється у рази.
Скільки пам'яті вільно насправді, показує стовпчик available:
free -h
grep -E "MemTotal|MemAvailable|SwapTotal" /proc/meminfo
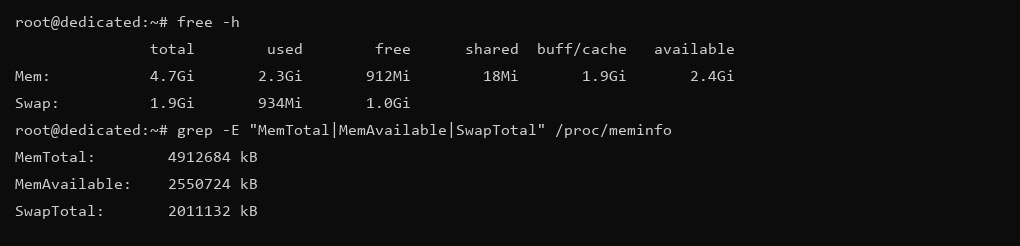
Тестовий VPS: з 4,7 ГБ доступно 2,4 ГБ. Цього вистачить лише на модель 1B.
CPU для Ollama: чи можна працювати без GPU?
Можна. Відеокарта для Ollama не є обов'язковою: якщо GPU немає, інференс виконується на процесорі. Сценарії, де цього достатньо:
-
знайомство з Ollama та порівняння моделей;
-
розробка і тестування інтеграцій через API;
-
невеликі моделі класу 1–4B;
-
внутрішні інструменти з нечастими запитами;
-
фонові задачі, де відповідь за кілька десятків секунд прийнятна: класифікація, теги, чернетки.
Обмеження одне — продуктивність. Невелика модель LLM на сучасному процесорі відповідає з прийнятною швидкістю, 7B або 8B помітно повільніше, а на 14B кожен абзац доводиться чекати. Чим більша модель, тим сильніше розрив між CPU та GPU.
Обираючи CPU для Ollama, дивіться на чотири параметри: продуктивність ядра, кількість фізичних ядер, пропускну здатність пам'яті та покоління архітектури. Генерація тексту постійно читає ваги з пам'яті, тому швидка пам'ять DDR5 дає більше, ніж кілька додаткових потоків.
Процесор сервера перевіряють трьома командами. Остання показує підтримку AVX2: без цих інструкцій обчислення йдуть значно повільніше.
nproc
lscpu | grep -E "^(Model name|CPU.s.:|Thread|Core)"
grep -o -w -E "avx2|avx512f" /proc/cpuinfo | sort -u
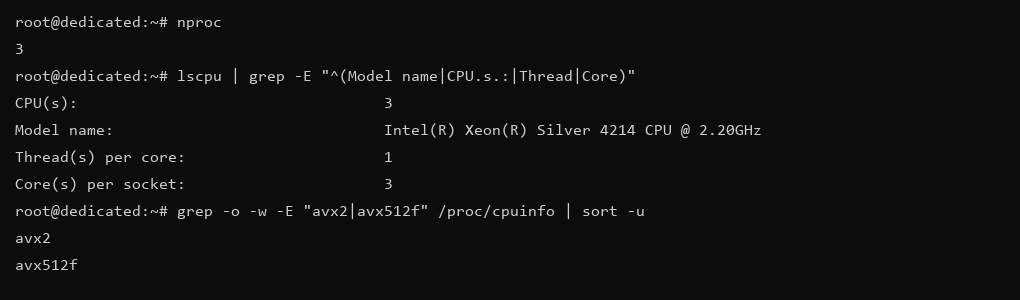
Тестовий VPS: 3 ядра Xeon Silver 4214, AVX2 та AVX-512 доступні.
GPU та VRAM для LLM
RAM — оперативна пам'ять сервера. VRAM — відеопам'ять, розпаяна на самій відеокарті. Вона не розширюється і не ділиться з системою. Коли інференс виконується на GPU, модель разом із KV cache має поміститися саме у VRAM: тоді швидкість генерації зростає в рази.
Обсяг відеопам'яті важить більше, ніж модель графічного чипа. NVIDIA RTX 5060 має 8 ГБ VRAM, RTX 5060 Ti — 16 ГБ. Друга карта вміщує значно більші моделі або ту саму модель з довшим контекстом. Ollama працює з картами NVIDIA через CUDA, для цього на сервері потрібен актуальний драйвер.
Чи є на сервері відеокарта, видно зі списку PCI-пристроїв:
lspci | grep -i -E "vga|3d|display"
lspci | grep -c -i nvidia
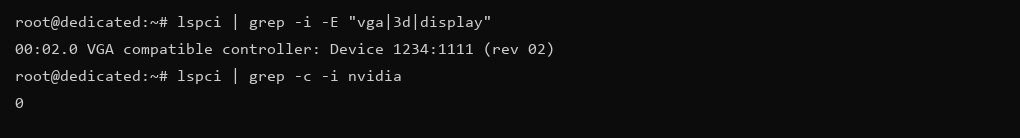
На звичайному VPS є лише віртуальний адаптер, тому модель працюватиме на процесорі.
Спрощення «8 ГБ VRAM = будь-яка 8B модель» некоректне. Qwen3 8B займає 5,2 ГБ і поміщається із запасом на контекст, але з вікном у десятки тисяч токенів вона вже вийде за межі 8 ГБ. Скільки потрібно VRAM для LLM, залежить від моделі, квантизації, контекстного вікна та розміру KV cache.
Якщо модель не поміщається у відеопам'ять цілком, Ollama розділить її між GPU та CPU. Ollama сервер запуститься, але частина шарів працюватиме на процесорі, і продуктивність впаде. Тому GPU для Ollama підбирають так, щоб модель була на відеокарті повністю.
Коли GPU справді потрібна
-
користувач чекає відповідь у чаті, і важлива швидкість;
-
модель працює постійно, а не кілька разів на день;
-
надходять одночасні запити від кількох людей або сервісів;
-
потрібні моделі від 12–14B;
-
LLM працює у production;
-
на сервері є інші задачі під CUDA: embeddings, розпізнавання мови, генерація зображень.
Для тесту невеликої моделі орендувати GPU-сервер не обов'язково. GPU для Ollama виправдана там, де швидкість безпосередньо впливає на роботу людей.
SSD та NVMe
Моделі займають від одного до десятків гігабайтів кожна, і на сервері їх рідко буває одна. У розрахунок диска закладайте:
-
кілька моделей для порівняння;
-
операційну систему, наприклад Ubuntu Server;
-
образи та томи Docker, якщо Ollama працює в контейнері;
-
документи для RAG і векторну базу;
-
резерв 20–30% під журнали та оновлення.
NVMe скорочує час завантаження моделі з диска в пам'ять: на 19 ГБ різниця із SATA SSD помітна. Після завантаження диск у генерації не бере участі, тому на кількість токенів за секунду NVMe не впливає.
Вільне місце перевірте до завантаження моделей:
df -h /
lsblk -dn -o NAME,SIZE,TYPE
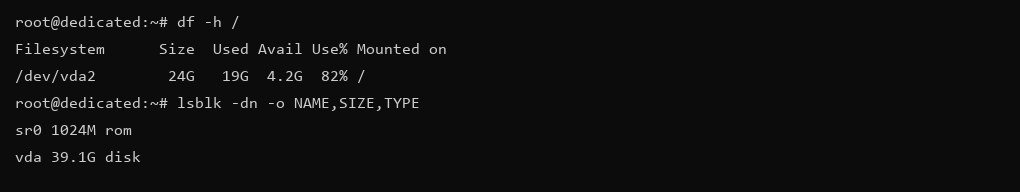
На тестовому VPS вільно 4,2 ГБ із 24 ГБ: цього досить для однієї моделі 1B.
Читайте також:Закінчується місце на VPS: як знайти, що займає диск в Ubuntu
Якщо на сервері недостатньо вільного місця для завантаження моделей Ollama, не поспішайте збільшувати диск. У нашій статті розповідаємо, як знайти файли та каталоги, що займають найбільше місця, перевірити журнали й кеш та безпечно звільнити дисковий простір в Ubuntu.
VPS чи виділений сервер
VPS
Віртуальний сервер підходить для знайомства з Ollama, невеликих моделей на CPU, розробки та тестів з малим навантаженням. Головна перевага — низький поріг входу: можна почати з недорогого тарифу і перейти на старший, коли пам'яті стане мало. Для контейнерного розгортання зручно взятиVPS з передвстановленим Docker.
Виділений сервер
Без відеокарти
Потрібен, коли VPS уже недостатньо: модель вимагає 32–64 ГБ RAM, Ollama сервер працює цілодобово, а локальна LLM не має ділити процесор із сусідами. Швидкість буде нижчою, ніж на відеокарті, але для пакетної обробки цього вистачає.
GPU-сервер
Виділений сервер з відеокартою — вибір для production, середніх і великих моделей, чатів з кількома користувачами та AI-сервісів, де затримка відповіді критична.
Приклади конфігурацій FREEhost.UA
Нижче — серверна конфігурація під кожен сценарій: від першого тесту до сервера для локальних LLM середнього розміру.
| Сервер | Ресурси | Для чого розглядати |
|---|---|---|
| CLOUD 3 VPS | 4 CPU, 8 ГБ RAM, 60 ГБ SSD | Знайомство з Ollama, моделі 1–3B |
| CLOUD 4 VPS | 5 CPU, 10 ГБ RAM, 80 ГБ SSD | Невеликі моделі, розробка і тести |
| CLOUD 3 RAM VPS | 3 CPU, 14 ГБ RAM, 60 ГБ SSD | Моделі класу 7B–8B на CPU |
| Intel i5-14400 | 10 ядер / 16 потоків, до 64 ГБ RAM | Постійний інференс на CPU, моделі до 14B |
| Ryzen 5 7600 + RTX 5060 | 8 ГБ VRAM, 32–128 ГБ RAM | Невеликі та середні моделі на GPU |
| Ryzen 7 7700 + RTX 5060 Ti | 16 ГБ VRAM, 32–128 ГБ RAM | Моделі 12–14B, довший контекст, кілька користувачів |
Таблиця показує, що орієнтовно підходить для задачі, і не обіцяє конкретної швидкості. Кількість токенів за секунду залежить від моделі, квантизації та довжини контексту, тому перед запуском у роботу проведіть власний тест. Моделі класу 32B і 70B не поміщаються у 16 ГБ VRAM: на таких конфігураціях вони працюватимуть із частковим перенесенням на процесор.
Перевірка на тестовому VPS
Щоб орієнтири не лишалися теорією, ми запустили Llama 3.2 1B на цьому ж VPS без відеокарти. Запуск підтвердив розрахунки: модель з файлом на 1,3 ГБ зайняла в пам'яті 1,5 ГБ і працювала повністю на процесорі. Але така локальна LLM відповідає нестабільно. Ми поставили найпростіше питання п'ять разів поспіль:
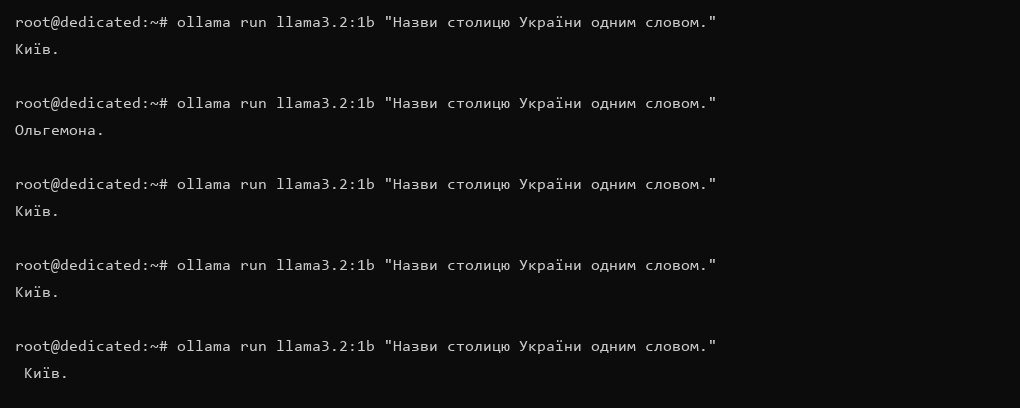
Чотири відповіді правильні, а в другій спробі модель вигадала слово «Ольгемона».
Обладнання визначає, чи модель запуститься, а якість відповідей залежить від її розміру. Тому сервер для локальних LLM підбирають під модель, яка справляється із задачею, а не навпаки.
Простий алгоритм вибору
-
Спробувати Ollama. VPS з 8–10 ГБ RAM і модель 1–3B.
-
Невелика внутрішня LLM. VPS з 14–16 ГБ RAM або виділений сервер без відеокарти.
-
Потрібна швидкість. Виділений сервер з GPU.
-
Модель 7–8B на GPU. Відеокарта від 8 ГБ VRAM, з поправкою на контекст.
-
Моделі 12–14B і більші. Від 16 ГБ VRAM.
Це орієнтири, а не універсальні вимоги. Сервер для Ollama під тест і під production — різні машини. Остаточна серверна конфігурація залежить від моделі та навантаження, тому надійніше почати з меншого тарифу і виміряти результат.
З чого почати
Для першого знайомства дорогий GPU-сервер не потрібен. Невеликі локальні LLM працюють на віртуальному сервері з достатнім обсягом оперативної пам'яті: підійдеVPS для Ollama з 8–14 ГБ RAM. Якщо Ollama сервер використовується постійно або важлива швидкість відповіді, варто перейти навиділений сервер для LLM. У FREEhost.UA є сервери з великим обсягом RAM і конфігурації з NVIDIA RTX 5060 та RTX 5060 Ti.
Вибір сервера — лише перший крок. У наступній статті ми на практиці встановимо Ollama на Ubuntu Server, завантажимо локальну модель, перевіримо використання CPU, RAM та GPU і покажемо, як звертатися до неї через API.
Підписуйтеся на наш Telegram-каналhttps://t.me/freehostua, щоб бути в курсі нових корисних матеріалів.
Дивіться наш канал YouTube за посиланням https://www.youtube.com/freehostua.
Ми у чомусь помилилися, чи щось пропустили?
Напишіть про це у коментарях, ми із задоволенням відповімо та обговоримо ваші зауваження та пропозиції.
|
Дата: 12.10.2026 Автор: Ілля Пігович
|
|
Авторам статті важлива Ваша думка. Будемо раді його обговорити з Вами:
comments powered by Disqus