


Мы уверенны что среди наших клиентов, есть много профессионалов IT, работающих над интересными проектами. Если у Вас возникает желание рассказать о них, Вы можете разместить статью в нашем блоге. А чтоб было интересней, мы сделали конкурс статей, каждый месяц три победителя будут получать призы.
Статья также доступна на украинском (перейти к просмотру).
Оглавление:
Можно ли запустить собственную языковую модель на обычном VPS или для этого обязательно нужен мощный сервер с GPU? Все зависит от размера модели, объема оперативной памяти и требований к скорости работы. Например, для запуска небольшой LLM с 3 миллиардами параметров может хватить обычного VPS, тогда как модель с 30 миллиардами параметров потребует гораздо больше ресурсов.
В этой статье разберемся, как правильно подобрать сервер для Ollama: сколько нужно RAM и VRAM, когда достаточно процессора без видеокарты, а когда следует выбирать GPU. Также рассмотрим конкретные конфигурации серверов для запуска моделей разного размера.
Что такое Ollama и зачем собственная LLM
Ollama – инструмент для запуска языковых моделей на собственном оборудовании. Он работает на Linux, MacOS и Windows, загружает модели из каталога одной командой и открывает к ним HTTP API. В каталоге есть Llama, Qwen, Gemma и десятки других семейств. Модели распространяются в формате GGUF: один файл GGUF содержит веса модели и метаданные.
Запуск Ollama на сервере занимает несколько минут, а запуск LLM локально выбирают по практическим причинам:
-
документы и переписка не передаются стороннему API;
-
нет оплаты за каждый запрос, расходы сводятся к аренде сервера;
-
модель подключается к внутренним системам: CRM, базы знаний, тикет-системы;
-
можно собрать внутреннего ассистента для сотрудников;
-
локальная LLM подходит для RAG, обработки документов и классификации текстов.
Главное правило: сначала модель, затем сервер
Сервер для AI невозможно подобрать "вообще". Сначала определяют задачу и модель LLM под нее и только потом смотрят на аппаратные ресурсы. Локальные LLM одного названия бывают в нескольких размерах, и аппаратные ресурсы под них разные. Llama 3.2 3B и Qwen3 30B отличаются по размеру почти в десять раз, поэтому сервер для локальных LLM под первую и во вторую – это разные классы оборудования.
На требования влияют шесть вещей:
-
сколько параметров имеет модель LLM;
-
уровень квантизации;
-
контекстное окно, то есть, сколько текста модель держит в памяти одновременно;
-
одновременные запросы от нескольких пользователей;
-
где выполняется инференс (inference) – на CPU или на GPU;
-
нужна скорость генерации.
Что означают 3B, 8B, 14B, 30B
Буква B в названии – это миллиарды параметров: 3B ≈ 3 млрд, 8B ≈ 8 млрд, 14B ≈ 14 млрд, 30B ≈ 30 млрд. Чем больше параметров, тем больше памяти нужно, чтобы держать модель загруженной. LLM расшифровывается как большая языковая модель, и слово «большое» здесь буквальное. Старшая большая языковая модель обычно лучше рассуждает и точнее следует инструкциям, но платить за это приходится гигабайтам памяти.
Прямо перечислять параметры в гигабайты нельзя, потому что есть такая вещь, как квантизация. Она уменьшает размер модели и требования к памяти по цене определенной потери точности. Модели в каталоге Ollama уже типично квантизированы, поэтому 8B занимает около 5 ГБ, а не 16 ГБ, как в полной точности.
Примеры реальных моделей
Размеры типовых тегов в каталоге Ollama на момент подготовки материала:
| Класс модели | Ориентир по RAM |
|---|---|
| 1–3B | 4–8 ГБ и больше |
| 4–8B | 8–16 ГБ и больше |
| 12–14B | 16–32 ГБ и больше |
| Около 30B | 32–64 ГБ и больше |
| 70B | 64–128 ГБ и больше |
Размер файла – это нижний предел, а не нужный объем RAM или VRAM. Помимо веса самой модели память занимают:
-
операционная система и процесс Ollama;
-
контекст – токены запроса, истории диалога и ответа;
-
KV cache, промежуточные данные для уже обработанных токенов;
-
параллельные запросы, каждый со своим контекстом.
По умолчанию Ollama выделяет контекстное окно на 4096 токенов. Если увеличить его до 32 тысячи ради длинных документов, KV cache вырастет пропорционально, и модель на 5 ГБ может занять вдвое больше. По документации Ollama, потребность в памяти под контекст умножается на количество параллельных запросов. Поэтому запас нужен всегда.
RAM для Ollama: сколько оперативной памяти нужно
Когда видеокарты нет, модель полностью размещается в оперативной памяти сервера. Именно RAM определяет, какая модель LLM вообще загрузится. Ориентиры для квантизированных моделей с типичным контекстом:
| Модель | Параметры | Размер файла |
|---|---|---|
| Llama 3.2 | 1B | ~1,3 ГБ |
| Llama 3.2 | 3B | ~2,0 ГБ |
| Qwen3 | 4B | ~2,5 ГБ |
| Qwen3 | 8B | ~5,2 ГБ |
| Gemma 3 | 12B | ~8,1 ГБ |
| Qwen3 | 14B | ~9,3 ГБ |
| Qwen3 | 30B | ~19 ГБ |
| Qwen3 | 32B | ~20 ГБ |
Это не системные требования, а точка отсчета: реальные цифры зависят от модели, квантизации и контекста. Подбирая RAM для Ollama, берите конфигурацию, где модель занимает не больше двух третей памяти. Если она вплотную заполняет оперативную память, система уходит в swap, и генерация текста замедляется в разы.
Сколько памяти свободно на самом деле, показывает столбец available:
free -h
grep -E "MemTotal|MemAvailable|SwapTotal" /proc/meminfo
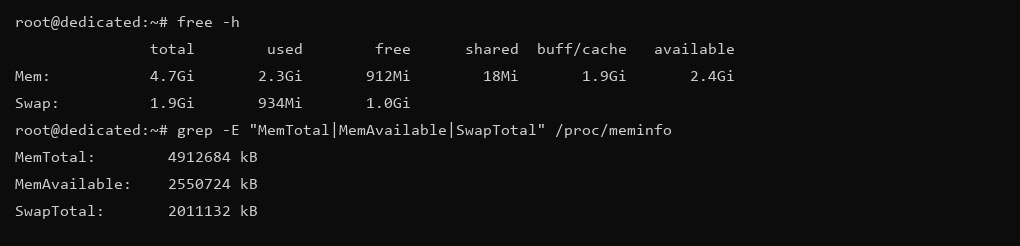
Тестовый VPS: с 4,7 ГБ доступно 2,4 ГБ. Этого хватит только на модель 1B.
CPU для Ollama: можно ли работать без GPU?
Можно. Видеокарта для Ollama не обязательна: если GPU нет, инференс выполняется на процессоре. Сценарии, где этого достаточно:
-
знакомство с Ollama и сравнение моделей;
-
разработка и тестирование интеграций через API;
-
небольшие модели класса 1-4B;
-
внутренние инструменты с нечастыми запросами;
-
фоновые задачи, где ответ за несколько десятков секунд приемлем: классификация, теги, черновики.
Ограничение одно – производительность. Небольшая модель LLM на современном процессоре отвечает с приемлемой скоростью, 7B или 8B заметно медленнее, а 14B каждый абзац приходится ждать. Чем больше модель, тем сильнее разрыв между CPU и GPU.
Выбирая CPU для Ollama, смотрите четыре параметра: производительность ядра, количество физических ядер, пропускную способность памяти и поколение архитектуры. Генерация текста постоянно читает весы из памяти, поэтому быстрая память DDR5 дает больше нескольких дополнительных потоков.
Процессор сервера проверяют тремя командами. Последняя показывает поддержку AVX2: без этих инструкций вычисления идут гораздо медленнее.
nproc
lscpu | grep -E "^(Model name|CPU.s.:|Thread|Core)"
grep -o -w -E "avx2|avx512f" /proc/cpuinfo | sort -u
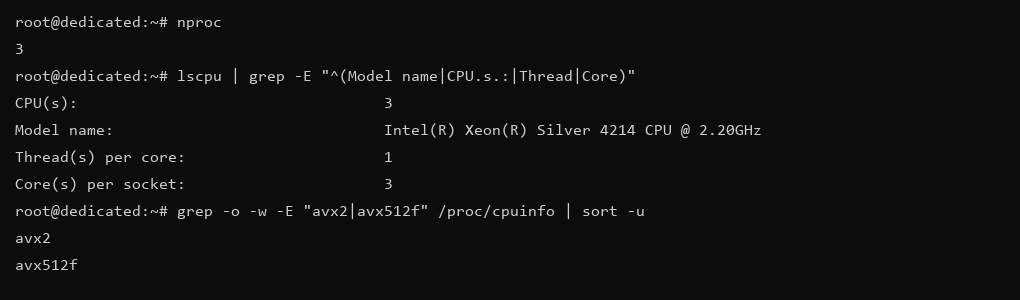
Тестовый VPS: 3 ядра Xeon Silver 4214, AVX2 и AVX-512 доступны.
GPU и VRAM для LLM
RAM – оперативная память сервера. VRAM – видеопамять, распаянная на самой видеокарте. Она не расширяется и не делится с системой. Когда инференс выполняется на GPU, модель вместе с KV cache должна разместиться именно в VRAM: тогда скорость генерации возрастает в разы.
Объем видеопамяти весит больше, чем модель графического чипа. NVIDIA RTX 5060 имеет 8 ГБ VRAM, RTX 5060 Ti — 16 ГБ. Вторая карта вмещает значительно большие модели или ту же модель с более длинным контекстом. Ollama работает с картами NVIDIA через CUDA, для этого на сервере требуется актуальный драйвер.
Есть ли на сервере видеокарта, видна из списка PCI-устройств:
lspci | grep -i -E "vga|3d|display"
lspci | grep -c -i nvidia
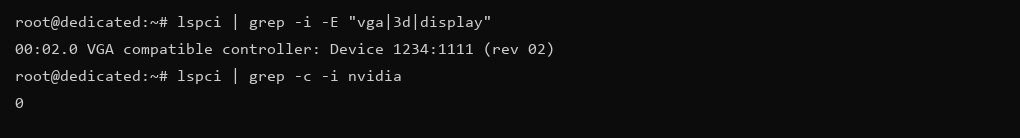
На обычном VPS есть только виртуальный адаптер, поэтому модель будет работать на процессоре.
Упрощение "8 ГБ VRAM = любая 8B модель" некорректно. Qwen3 8B занимает 5,2 ГБ и помещается с запасом на контекст, но с окном в десятки тысяч токенов она уже выйдет за пределы 8 ГБ. Сколько требуется VRAM для LLM зависит от модели, квантизации, контекстного окна и размера KV cache.
Если модель полностью не помещается в видеопамять, Ollama разделит ее между GPU и CPU. Ollama сервер запустится, но часть слоев будет работать на процессоре и производительность упадет. Потому GPU для Ollama подбирают так, чтобы модель была на видеокарте стопроцентно.
Когда GPU действительно нужна
-
пользователь ждет ответ в чате и важна скорость;
-
модель работает постоянно, а не несколько раз в день;
-
поступают одновременные запросы от нескольких человек или сервисов;
-
нужные модели от 12–14B;
-
LLM работает в production;
-
на сервере есть другие задачи под CUDA: embeddings, распознавание языка, генерация изображений.
Для теста небольшой модели арендовать GPU-сервер не обязательно. GPU для Ollama оправдана там, где скорость оказывает непосредственное влияние на работу людей.
SSD и NVMe
Модели занимают от одного до десятков гигабайтов каждый, и на сервере их редко бывает одна. В расчет диска закладывайте:
-
несколько моделей для сравнения;
-
операционную систему, например Ubuntu Server;
-
образы и тома Docker, если Ollama работает в контейнере;
-
документы для RAG и векторной базы;
-
резерв 20–30% под журналы и обновления.
NVMe сокращает время загрузки модели с диска в память: на 19 ГБ разница с SATA SSD заметна. После загрузки диск в генерации не участвует, поэтому количество токенов в секунду NVMe не влияет.
Свободное место проверьте загрузку моделей:
df -h /
lsblk -dn -o NAME,SIZE,TYPE
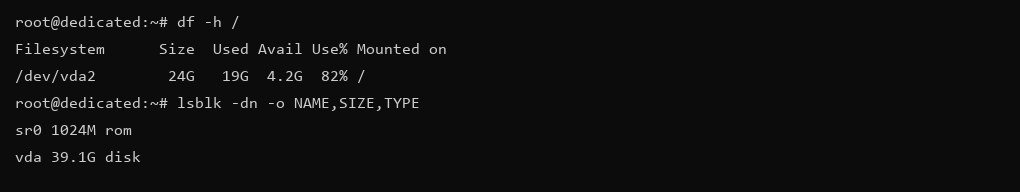
На тестовом VPS свободно 4,2 ГБ с 24 ГБ: этого достаточно для одной модели 1B.
Читайте также: Заканчивается место на VPS: как найти, что занимает диск в Ubuntu
Если на сервере недостаточно свободного места для загрузки моделей Ollama, не торопитесь увеличивать диск. В нашей статье рассказываем, как найти файлы и каталоги, занимающие наибольшее место, проверить журналы и кэш и безопасно освободить дисковое пространство в Ubuntu.
VPS или выделенный сервер
VPS
Виртуальный сервер подходит для знакомства с Ollama, небольших моделей на CPU, разработки и тестов с малой нагрузкой. Главное преимущество – низкий порог входа: можно начать с недорогого тарифа и перейти на старший, когда памяти станет мало. Для контейнерного развертывания удобно взять VPS с предустановленным Docker.
Выделенный сервер
Без видеокарты
Нужен, когда VPS уже недостаточно: модель требует 32-64 ГБ RAM, сервер Ollama работает круглосуточно, а локальная LLM не должна делить процессор с соседями. Скорость будет ниже, чем на видеокарте, но для пакетной обработки этого достаточно.
сервер с графическим процессором
Выделенный сервер с видеокартой – выбор для production, средних и больших моделей, чатов с несколькими пользователями и AI-сервисов, где задержка ответа критическая.
Примеры конфигураций FREEhost.UA
Ниже – серверная конфигурация под каждый сценарий: от первого теста до сервера для локальных LLM среднего размера.
| Сервер | Ресурсы | Для чего рассматривать |
|---|---|---|
| VPS Cloud 3 | 4 процессора, 8 ГБ оперативной памяти, 60 ГБ SSD | Знакомство с Ollama, модели 1–3B |
| CLOUD 4 VPS | 5 процессоров, 10 ГБ оперативной памяти, 80 ГБ SSD | Небольшие модели, разработка и тесты |
| Cloud 3 RAM VPS | 3 процессора, 14 ГБ оперативной памяти, 60 ГБ SSD | Модели класса 7B–8B на CPU |
| Intel i5-14400 | 10 ядер / 16 потоков, до 64 ГБ RAM | Постоянный инференс на CPU, модели до 14B |
| Ryzen 5 7600 + RTX 5060 | 8 ГБ VRAM, 32–128 ГБ RAM | Небольшие и средние модели на GPU |
| Ryzen 7 7700 + RTX 5060 Ti | 16 ГБ VRAM, 32–128 ГБ RAM | Модели 12–14B, более длинный контекст, несколько пользователей |
Таблица показывает, что ориентировочно подходит для задачи и не сулит конкретной скорости. Количество токенов в секунду зависит от модели, квантизации и длины контекста, поэтому перед запуском в работу проведите тест. Модели класса 32B и 70B не помещаются в 16 ГБ VRAM: на таких конфигурациях они будут работать с частичным переносом на процессор.
Проверка на тестовом VPS
Чтобы ориентиры не оставались теорией, мы запустили Llama 3.2 1B на этом же VPS без видеокарты. Запуск подтвердил расчеты: модель с файлом на 1,3 ГБ заняла в памяти 1,5 ГБ и полностью работала на процессоре. Но такая локальная LLM отвечает нестабильно. Мы задали простейший вопрос пять раз подряд:
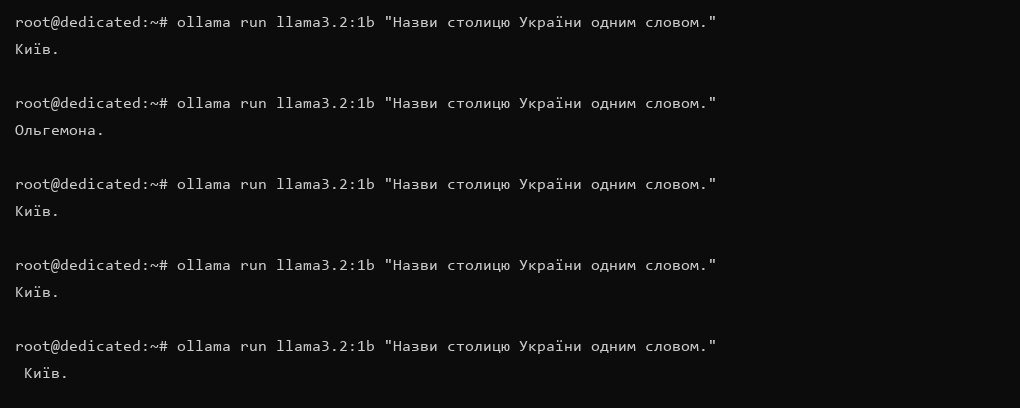
Четыре ответа правильные, а во второй попытке модель придумала слово «Ольгемона».
Оборудование определяет, запустится ли модель, а качество ответов зависит от ее размера. Поэтому сервер для локальных LLM подбирается под модель, которая справляется с задачей, а не наоборот.
Простой алгоритм выбора
-
Попробуйте Ollama. VPS с 8–10 ГБ RAM и модель 1–3B.
-
Небольшая внутренняя LLM. VPS с 14-16 ГБ RAM или выделенный сервер без видеокарты.
-
Нужна скорость. Выделенный сервер с GPU.
-
Модель 7–8B на GPU. Видеокарта от 8 ГБ VRAM с поправкой на контекст.
-
Модели 12–14B и больше. От 16 ГБ VRAM.
Это ориентиры, а не универсальные требования. Сервер для Ollama под тест и под production – разные машины. Окончательная серверная конфигурация зависит от модели и нагрузки, поэтому надежнее начать с меньшего тарифа и измерить результат.
С чего начать
Для первого знакомства дорогой GPU-сервер не требуется. Небольшие локальные LLM работают на виртуальном сервере с достаточным объемом оперативной памяти: подойдет VPS для Ollama с 8–14 ГБ RAM. Если сервер Ollama используется постоянно или важна скорость ответа, следует перейти на выделенный сервер для LLM. У FREEhost.UA есть серверы с большим объемом RAM и конфигурации с NVIDIA RTX 5060 и RTX 5060 Ti.
Выбор сервера – только первый шаг. В следующей статье мы на практике’ установим Ollama на Ubuntu Server, загрузим локальную модель, проверим использование CPU, RAM и GPU и покажем, как обращаться к ней через API.
Подписывайтесь на наш Telegram-каналhttps://t.me/freehostua, чтобы быть в курсе новых полезных материалов
Смотрите наш канал YouTube по ссылке https://www.youtube.com/freehostua.
Мы в чем-то ошиблись, или что-то пропустили?
Напишите об этом в комментариях, мы с удовольствием ответим и обсудим ваши замечания и предложения.
|
Дата: 12.10.2026 Автор: Илья Пигович
|
|
Авторам статьи важно Ваше мнение. Будем рады его обсудить с Вами:
comments powered by Disqus